Vue d'ensemble
Contexte
Un média disposait d’un fonds de plus de 22 000 vidéos, réparties entre un serveur réseau (NAS) et un stockage cloud, sans transcription ni sous-titres. Des années de contenu impossibles à rechercher, à réutiliser ou à rendre accessibles.
L’enjeu : construire, au sein de l’équipe et en s’intégrant à l’architecture existante, un pipeline capable de traiter ce volume en continu et sans supervision.
Approche
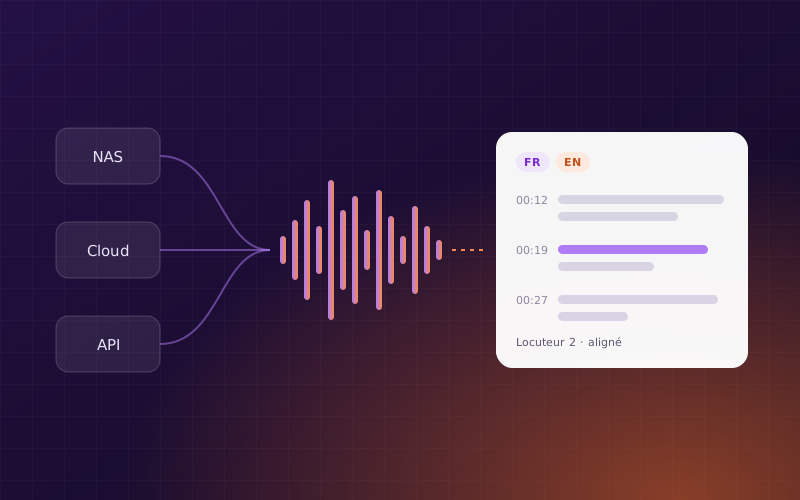
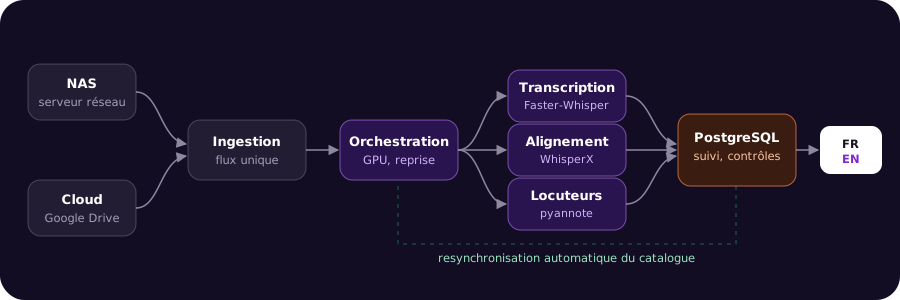
- Ingestion unifiée : les sources réseau et cloud sont réunies derrière une architecture commune, en coordination avec l’équipe chargée des autres briques du système.
- Orchestration de modèles IA sur GPU : Faster-Whisper pour la transcription, WhisperX pour l’alignement mot à mot, pyannote.audio pour identifier les locuteurs.
- Bilingue sans configuration : chaque langue détectée dans une vidéo produit sa propre transcription complète et alignée.
- Suivi en base PostgreSQL : l’avancement de chaque vidéo est tracé en temps réel.
Fiabilité en conditions réelles
- Reprise automatique à plusieurs niveaux : réseau instable, sessions expirées, plantages du GPU. Chaque mécanisme a été conçu après le diagnostic de la classe d’incident correspondante.
- Restructuration d’un schéma de base de données en production, sans perte : audit préalable, sauvegarde, puis migration.
- Détection d’un écart majeur entre le catalogue indexé et le contenu réel, puis mise en place d’une resynchronisation automatique.
Résultats
Environ 130 heures de contenu transcrites, soit près d’un million de mots, et un pipeline conçu pour traiter sans surveillance des lots de plusieurs milliers de vidéos.
En chiffres
15 To+de contenus audio et vidéo traités
130 hde contenu transcrites, soit environ 1 million de mots
0perte de données lors de la migration du schéma en production
Aperçu
Stack et liens
- Python
- Faster-Whisper
- WhisperX
- pyannote.audio
- PostgreSQL
- API REST